大二上在学python,所以想要用python实现一下课表爬取。
(虽然python开课爬虫不怎么讲的都
本文仅供学习使用。
广州大学课程信息查询脚本
1. 概述
本脚本用于自动化登录广州大学教务系统,获取当前学期课程信息,主要功能包括:
- 通过浏览器自动化(Selenium)模拟用户登录,绕过滑块验证。
- 使用获取的Cookie通过
requests库发送API请求,获取课程数据。 - 结构化处理课程信息,并导出为JSON和CSV格式文件。
2. 环境依赖
2.1 运行环境
- Python 3.7+
- 依赖库
bash pip install selenium requests pandas
2.2 配置
- 手动输入学号密码(脚本运行时会提示),查询时段的配置请求参数
- 后期待完善(
3. 功能模块
3.1 登录模块
功能描述
- 通过Selenium启动浏览器,访问教务系统登录页面。
- 自动填充学号、密码,并绕过滑块验证。
- 判断登录状态,成功后保存Cookie供后续请求使用。
输入参数
- 学号(
login_username) - 密码(
login_password)
关键逻辑
- 浏览器配置:禁用自动化检测标志(
excludeSwitches: ['enable-automation']),防止被识别为爬虫。 - 滑块验证绕过:通过执行JavaScript代码
navigator.webdriver = false。 - 登录状态检查:通过页面元素或关键词(如
登录成功)判断是否登录成功。
3.2 课程数据获取模块
功能描述
- 使用
requests库发送POST请求,携带登录后的Cookie和参数,获取课程数据。 - 数据接口:
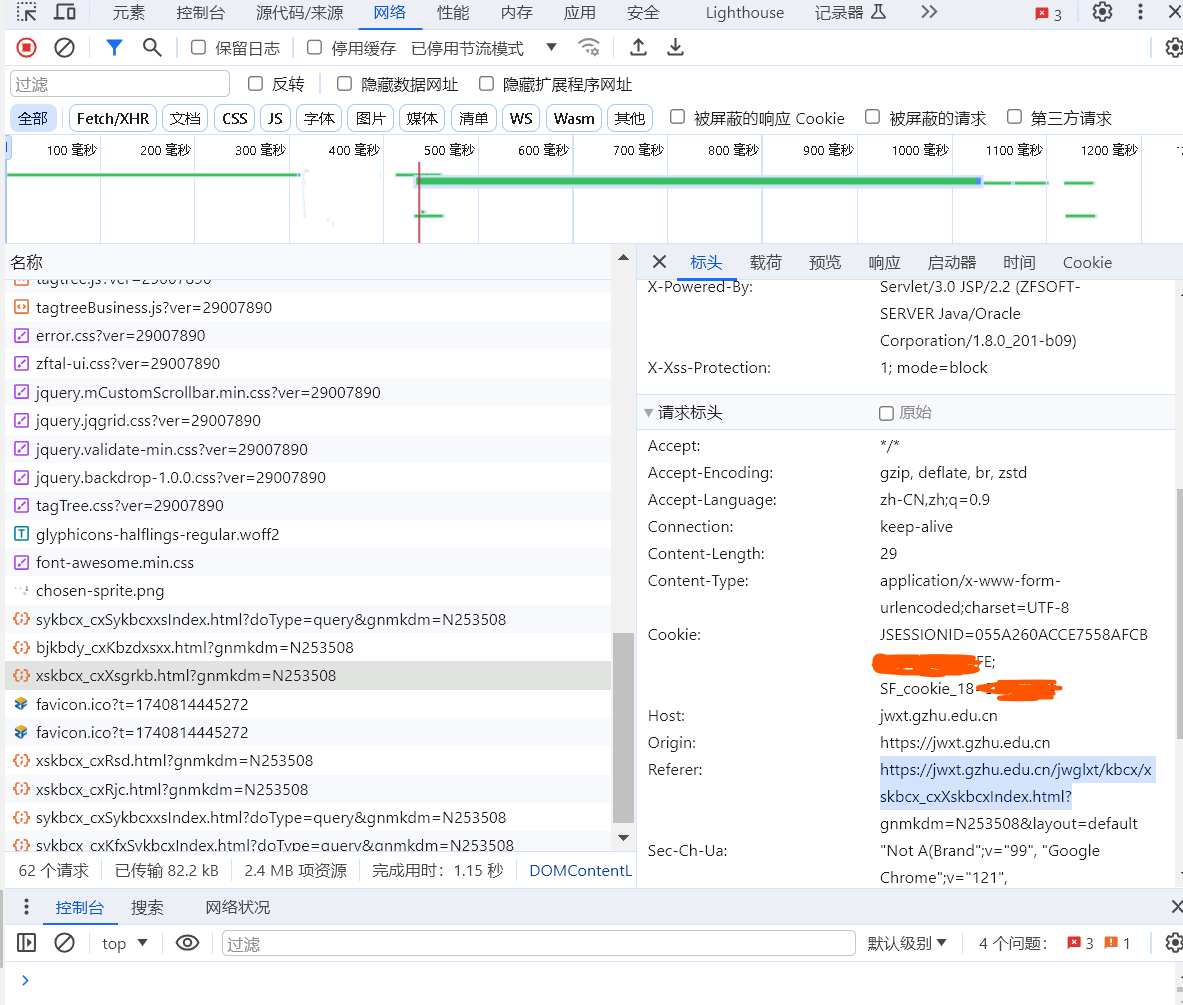
http://jwxt.gzhu.edu.cn/jwglxt/kbcx/xskbcx_cxXsgrkb.html(F12大法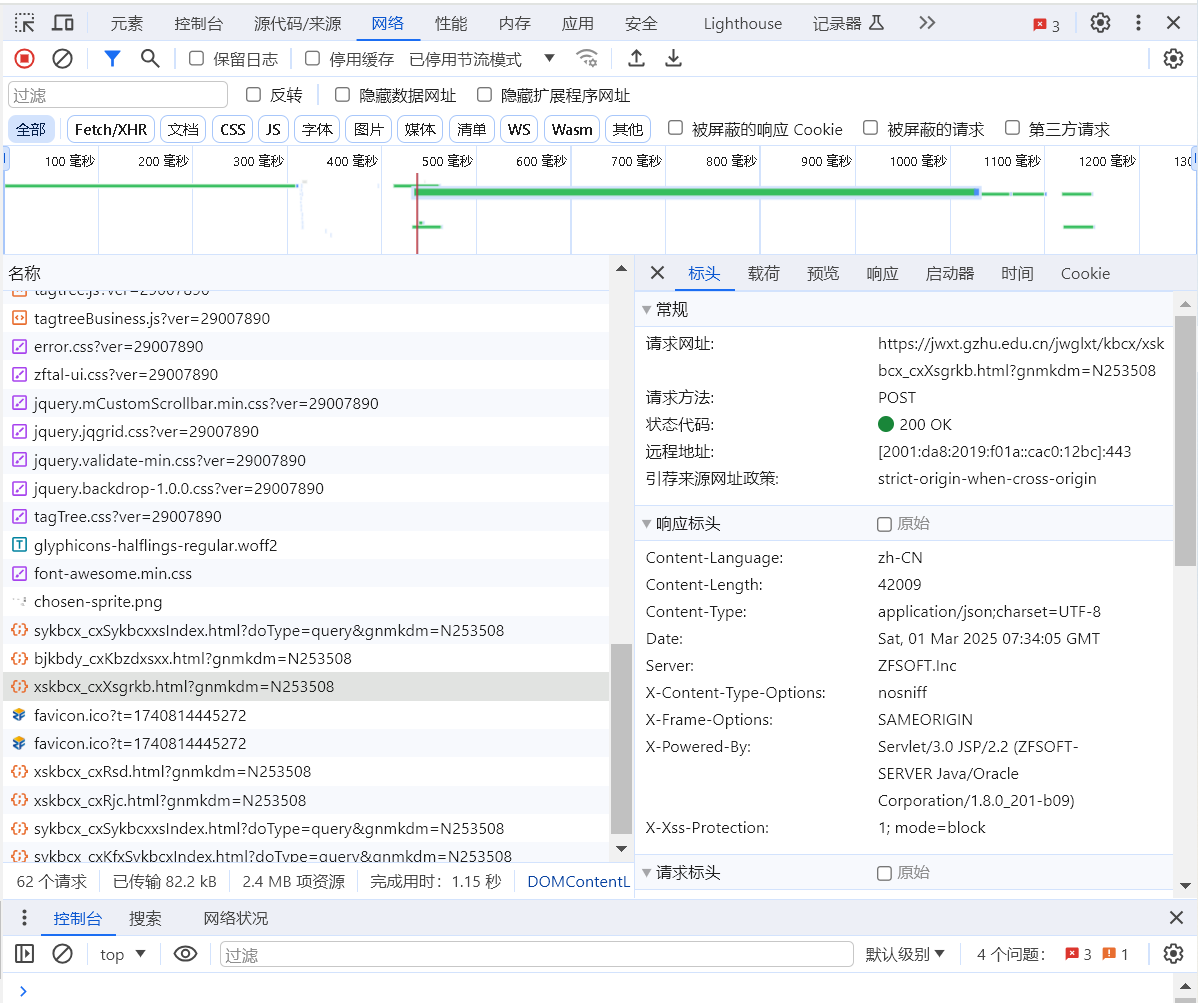
请求参数
data = {
    "xnm": "2024",     # 学年(2024表示2023-2024学年)
    "kzlx": "ck",      # 查询类型(ck=查看)
    "xsdm": "",        # 学生代码(留空)
    "xqm": "3"         # 学期码(3表示秋季学期)
}
请求头(Headers)
headers = {
    "User-Agent": "Mozilla/5.0 ...",  # 模拟浏览器请求
    "Referer": "http://jwxt.gzhu.edu.cn/...",  # 来源页面
    "X-Requested-With": "XMLHttpRequest"       # 标识AJAX请求
}
3.3 数据处理与导出模块
功能描述
- JSON数据处理
- 从原始响应中提取关键字段(如课程名称
kcmc、教室cdmc、节次jc)。 - 映射星期代码(
xqjmcMap)为中文(如1 → 周一)。 - 保存结构化的JSON文件(
extracted_courses.json)。
- 从原始响应中提取关键字段(如课程名称
- CSV导出
- 使用
pandas将JSON数据转换为表格形式。 - 添加中文表头(如“课程名称”、“教室”)。
- 导出为CSV文件(
courses.csv),兼容Excel打开。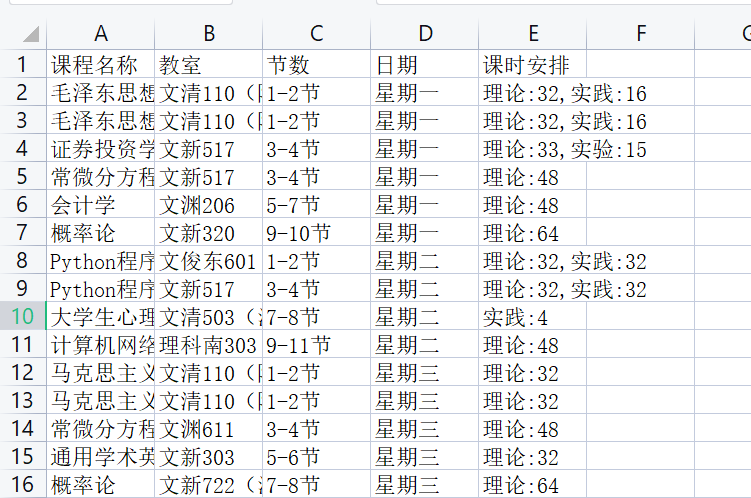
- 使用
字段映射表
| 原始字段 | 中文表头 | 说明 |
|---|---|---|
kcmc | 课程名称 | 课程全称 |
cdmc | 教室 | 上课地点 |
jc | 节数 | 课程节次(如1-2节) |
xqjmc | 日期 | 星期几(周一至日) |
kcxszc | 课时安排 | 周次范围(如1-16周) |
4. 代码详解
4.1 登录流程
# 防止打开浏览器后闪退
options = webdriver.ChromeOptions()
options.add_experimental_option('detach', True)
# options.add_argument('--headless')  # 无头模式

# 开发者模式,防止被各大网站识别出来使用了Selenium
options.add_experimental_option('excludeSwitches', ['enable-automation'])

# 启动浏览器
browser = webdriver.Chrome(options=options)
browser.get(login_url)

# 绕过滑块验证
browser.execute_script('Object.defineProperties(navigator,{webdriver:{get:()=>false}})')

# 查找用户名和密码输入框所在元素
username_input = browser.find_element(By.ID, 'un')
username_input.click()
username_input.send_keys(login_username)
# 等待响应
time.sleep(2)

# 输入信息模拟登录
password_input = browser.find_element(By.XPATH, "//input[@name='pd']")
password_input.click()
password_input.send_keys(login_password)

login_button = browser.find_element(By.ID, 'index_login_btn')
login_button.click()

time.sleep(5)

# 检查登录是否成功
if '登录成功' in browser.page_source or 'index_login_btn' not in browser.page_source:
    print("登录成功")
else:
    print("登录失败")

cookies = browser.get_cookies()
print("Cookies:", cookies)

cookie_dict = {cookie['name']: cookie['value'] for cookie in cookies}

# 关闭浏览器
browser.quit()
4.2 数据请求
# 请求头
headers = {
    "Accept": "*/*",
    "Accept-Encoding": "gzip, deflate",
    "Accept-Language": "zh-CN,zh;q=0.9",
    "Connection": "keep-alive",
    "Content-Length": "28",
    "Content-Type": "application/x-www-form-urlencoded;charset=UTF-8",
    "Host": "jwxt.gzhu.edu.cn",
    "Origin": "http://jwxt.gzhu.edu.cn",
    "Referer": "http://jwxt.gzhu.edu.cn/jwglxt/kbcx/xskbcx_cxXskbcxIndex.html?gnmkdm=███████&layout=default",
    "User-Agent": "Mozilla/███████ (Windows NT ███████; Win64; x64) AppleWebKit/███████ (KHTML, like Gecko) Chrome/121.0.0.0 Safari/537.36",
    "X-Requested-With": "XMLHttpRequest"
}

# 表单数据(学年和学期)
data = {
    "xnm": "2024",
    "kzlx": "ck",
    "xsdm": "",
    "xqm": "3"
}

session = requests.Session()

for name, value in cookie_dict.items():
    session.cookies.set(name, value)

# POST请求
response = session.post(target_url, headers=headers, data=data)

# 检查请求是否成功
if response.status_code == 200:
    try:
        response_data = response.json()
        formatted_data = json.dumps(response_data, indent=4, ensure_ascii=False)
        with open('course_schedule.json', 'w', encoding='utf-8') as file:
            file.write(formatted_data)
            print("返回的数据已经保存至course_schedule.json")

    except ValueError:
        print("无法解析JSON数据")
else:
    print(f"请求失败,状态码: {response.status_code}")
4.3 JSON数据处理
# 提取字段并重构数据
courses = []
for course in data['kbList']:
    course_info = {
        "课程名称": course.get('kcmc', ''),
        "教室": course.get('cdmc', ''),
        # ... 其他字段映射
    }
    courses.append(course_info)
4.4 CSV导出逻辑
# 使用pandas转换并导出
df = pd.DataFrame(courses)
df.to_csv('courses.csv', index=False, encoding='utf-8-sig')  # 兼容Excel中文编码
- 滑块验证更新:若教务系统更新滑块验证逻辑,需调整JavaScript绕过代码。
- 接口稳定性:课程查询接口(
xskbcx_cxXsgrkb.html)若变更URL,需同步更新。
6. 输出示例
6.1 JSON文件(extracted_courses.json)
和谐了部分隐私信息(
{
            "bklxdjmc": "无",
            "cd_id": "1015170",
            "cdlbmc": "多媒体",
            "cdmc": "███████517",
            "cxbj": "0",
            "cxbjmc": "无",
            "date": "二○二四年十一月十五日",
            "dateDigit": "2024年11月15日",
            "dateDigitSeparator": "2024-11-15",
            "day": "15",
            "jc": "3-4节",
            "jcor": "3-4",
            "jcs": "3-4",
            "jgh_id": "104119",
            "jgpxzd": "1",
            "jxb_id": "1850E3A697E512CAE06███████ACA210",
            "jxbmc": "(2024-2025-1)-216███████-01",
            "jxbsftkbj": "0",
            "jxbzc": "███████",
            "kcbj": "主修",
            "kch": "███████",
            "kch_id": "███████",
            "kclb": "专业课程平台",
            "kcmc": "常微分方程1",
            "kcxszc": "理论:48",
            "kcxz": "专选",
            "kczxs": "48",
            "khfsmc": "考试",
            "kkzt": "1",
            "lh": "███████楼",
            "listnav": "false",
            "localeKey": "zh_CN",
            "month": "11",
            "oldjc": "12",
            "oldzc": "65280",
            "pageTotal": 0,
            "pageable": true,
            "pkbj": "1",
            "px": "1",
            "qqqh": "无",
            "queryModel": {
                "currentPage": 1,
                "currentResult": 0,
                "entityOrField": false,
                "limit": 15,
                "offset": 0,
                "pageNo": 0,
                "pageSize": 15,
                "showCount": 10,
                "sorts": [],
                "totalCount": 0,
                "totalPage": 0,
                "totalResult": 0
            },
            "rangeable": true,
            "rk": "12",
            "rsdzjs": 0,
            "sfjf": "0",
            "skfsmc": "无",
            "sxbj": "1",
            "totalResult": "0",
            "userModel": {
                "monitor": false,
                "roleCount": 0,
                "roleKeys": "",
                "roleValues": "",
                "status": 0,
                "usable": false
            },
            "xf": "3",
            "xkbz": "无",
            "xm": "███████",
            "xnm": "2024",
            "xqdm": "0",
            "xqh1": "1,2,",
            "xqh_id": "1",
            "xqj": "1",
            "xqjmc": "星期一",
            "xqm": "3",
            "xqmc": "███████",
            "xsdm": "01",
            "xslxbj": "*",
            "year": "2024",
            "zcd": "9-███████周",
            "zcmc": "███████",
            "zfjmc": "主讲",
            "zhxs": "3",
            "zxs": "48",
            "zxxx": "无",
            "zyfxmc": "███████",
            "zyhxkcbj": "否",
            "zzrl": "███████"
        },
6.2 CSV文件(courses.csv)
| 课程名称 | 教室 | 节数 | 日期 | 课时安排 |
|---|---|---|---|---|
| 常微分方程1 | ███████ | 3-4 | 周一 | 1-16周 |
7. todo
- 可视化界面:集成
tkinter或Web框架(如Flask)提供GUI操作。 - 全校课表爬虫
�**