背景
RAG,全称Retrieval Augmented Generation(检索增强生成),其工作原理为:当用户提问时,系统先从海量知识库中检索出与问题相关的实时或私有信息,并将这些信息作为参考背景与问题一起提供给大模型,让模型像做开卷考试一样,基于提供的可靠证据生成更准确、实时且可溯源的回答。
https://arxiv.org/pdf/2005.11401 Facebook AI 2020 年提出 RAG 概念的开山之作,定义了「检索器 + 生成器」联合训练范式
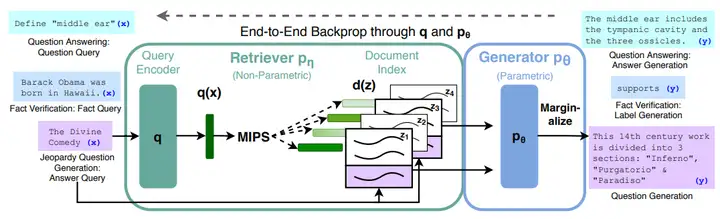
RAG主要通过两个阶段来完成这一过程:
(1)检索阶段:寻找“非参数化知识”
- 知识向量化:嵌入模型(Embedding Model) 充当了“连接器”的角色。它将外部知识库编码为向量索引(Index),存入向量数据库。
- 语义召回:当用户发起查询时,检索模块利用同样的嵌入模型将问题向量化,并通过相似度搜索(Similarity Search),从海量数据中精准锁定与问题最相关的文档片段。
(2)生成阶段:融合两种知识
- 上下文整合:生成模块接收检索阶段送来的相关文档片段以及用户的原始问题。
- 指令引导生成:该模块会遵循预设的 Prompt 指令,将上下文与问题有效整合,并引导 LLM(如 DeepSeek)进行可控的、有理有据的文本生成。
技术演进
RAG 的技术架构经历了从简单到复杂的演进,如图 1-2 大致可分为三个阶段 1。
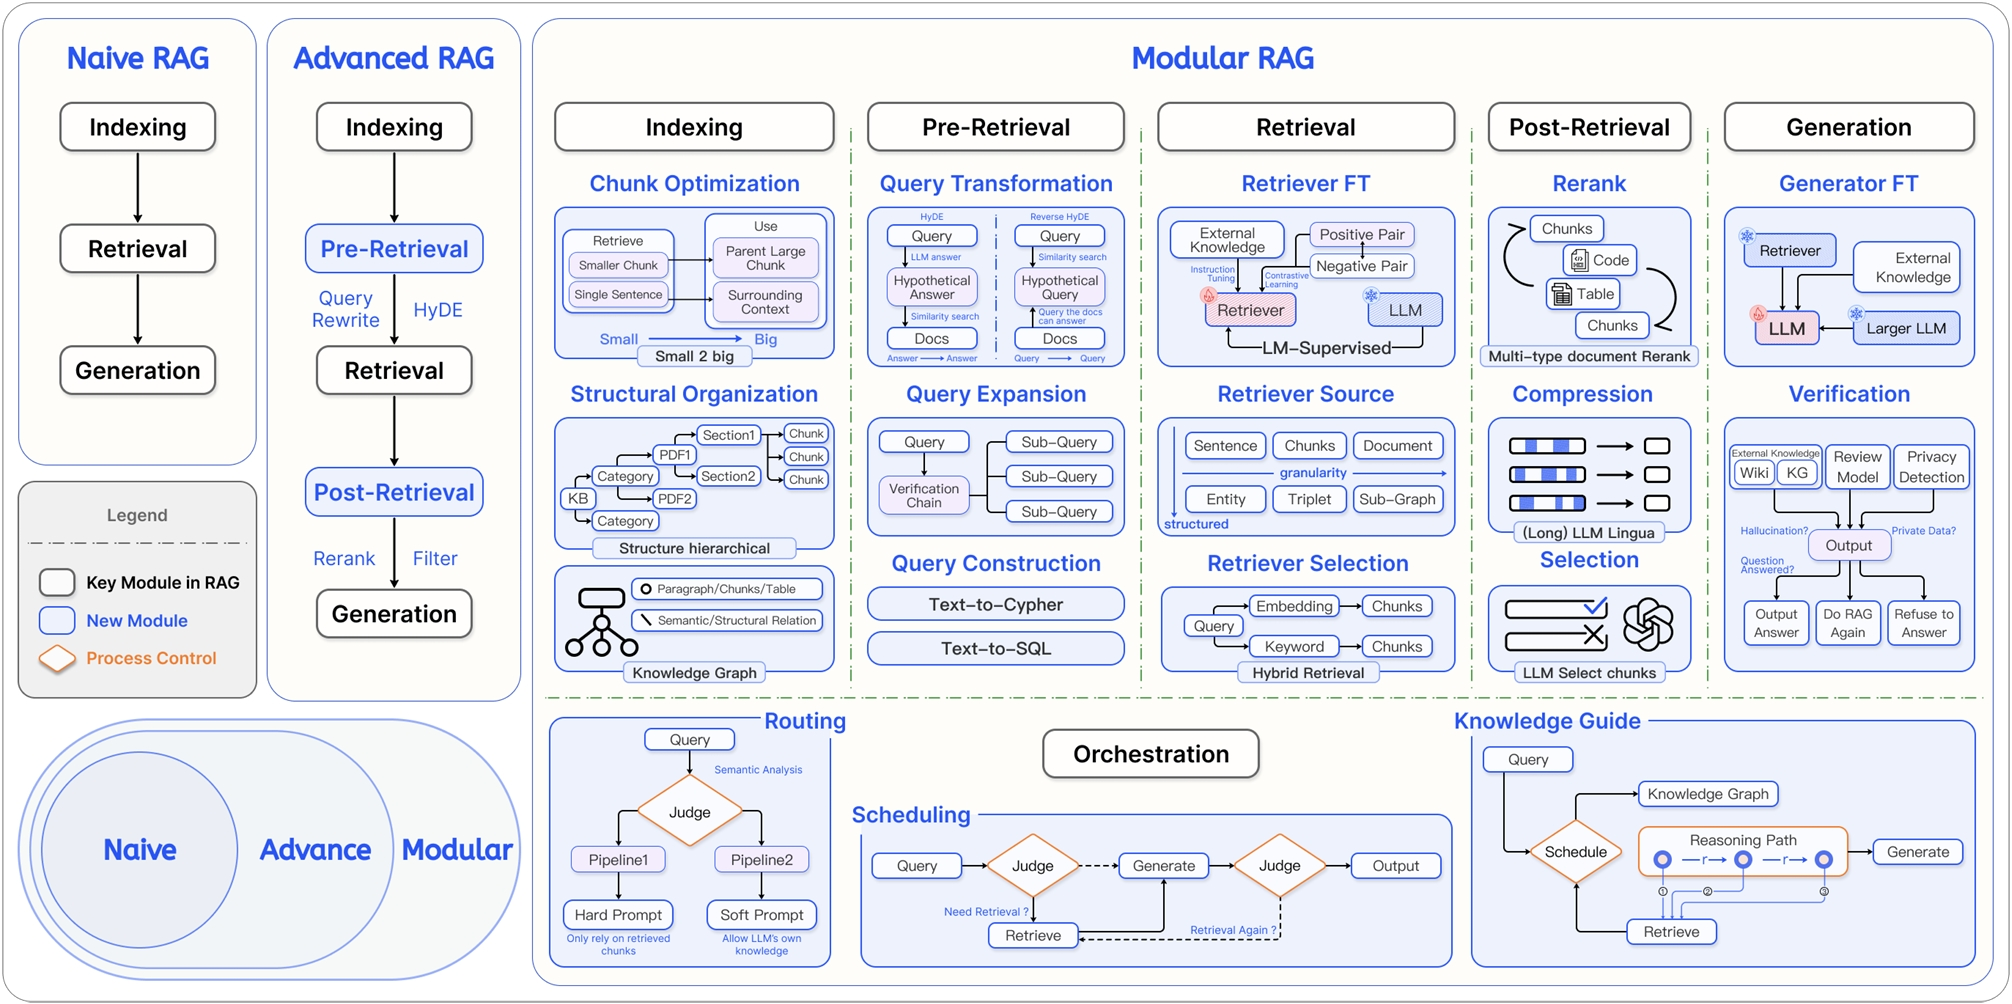
| Naive RAG | Advanced RAG | 模块化 RAG(Modular RAG) | |
|---|---|---|---|
| 流程 | 离线: 索引在线: 检索 → 生成 | 离线: 索引在线: ...→ 检索前 → ... → 检索后 → ... | 积木式可编排流程 |
| 特点 | 基础线性流程 | 增加检索前后的优化步骤 | 模块化、可组合、可动态调整 |
| 主要技术 | 基础向量检索 | 查询重写 结果重排 | 动态路由 查询转换 多路融合 |
| 局限性 | 效果不稳定,难以优化 | 流程相对固定,优化点有限 | 系统复杂性高 |
技术选型:RAG 与 微调
技术选型时比较重要的考量是成本与效益的平衡,优先选择对模型改动最小、成本最低的方案,所以一般从提示词工程到检索增强生成再到微调。
其中提示工程只是优化提问方式,而 RAG 则通过引入外部知识库,填补了通用模型与专业领域之间的鸿沟。当目标是改变模型“如何做”(行为/风格/格式)而不是“知道什么”(知识)时,微调是最终且最合适的选择。例如,让模型学会严格遵循某种独特的输出格式、模仿特定人物的对话风格,或者将极其复杂的指令“蒸馏”进模型权重中。
RAG 最主要的价值在于突破了模型预训练知识的限制,能补充专业领域的知识盲区,能通过提供具体的参考材料,抑制模型的幻觉现象。RAG 生成的内容在具体性和多样性上也显著优于纯 LLM。此外 RAG 具备可溯源性,回答都能找到对应的原始文档出处,提高了生成内容在法律、医疗等严肃场景下的可信度。
在知识更新方面,RAG 支持索引热拔插,解决了 LLM 固有的知识时滞问题(即模型不知道训练截止日期之后发生的事)。RAG 允许知识库独立于模型进行动态更新——新政策或新数据一旦入库,立刻就能被检索到。
从经济角度看,RAG 是一种高性价比的方案。首先,它避免了高频微调带来的巨额算力成本;其次,由于有了外部知识的强力辅助,我们在处理特定领域问题时,往往可以使用参数量更小的基础模型来达到类似的效果,从而直接降低了推理成本。减少了试图将海量知识强行“塞入”模型权重中所需的计算资源消耗。
RAG 的架构具备极强的包容性,支持多源集成,PDF、Word 以及网页数据都能统一构建进知识库中。同时其模块化设计实现了检索与生成的解耦,这意味着我们可以独立优化检索组件(比如更换更好的 Embedding 模型),而不会影响到生成组件的稳定性,便于系统的长期迭代。
另外就是RAG方便处理合规相关的问题。
构建RAG系统
构建 RAG 系统通常涉及几个关键环节的选型。
在开发模式上可以利用 LangChain 或 LlamaIndex 等成熟框架快速集成,也可以自己造轮子,对系统流程有更精细的控制力。记忆载体(向量数据库)方面,有 Milvus、Pinecone 等适合大规模数据的方案,也有 FAISS、Chroma 等轻量级或本地化的选择,根据具体业务规模灵活决定。后期为了量化效果,还可以引入 RAGAS 或 TruLens 等自动化评估工具。
最小可行系统(MVP)
(1)数据准备与清洗:这是系统的地基。我们需要将 PDF、Word 等多源异构数据标准化,并采用合理的分块策略(如按语义段落切分而非固定字符数),避免信息在切割中支离破碎。
(2)索引构建:将切分好的文本通过嵌入模型转化为向量,并存入数据库。可以在此阶段关联元数据(如来源、页码),这对后续的精确引用很有帮助。
(3)检索策略优化:不要依赖单一的向量搜索。可以采用混合检索(向量+关键词)等方式来提升召回率,并引入重排序模型对检索结果进行二次精选,确保 LLM 看到的都是精华。
(4)生成与提示工程:最后,设计一套清晰的 Prompt 模板,引导 LLM 基于检索到的上下文回答用户问题,并明确要求模型“不知道就说不知道”,防止幻觉。
进阶
当基础的 RAG 系统搭建完成后,下一步的进阶之路便聚焦于如何评估、诊断并突破其固有的瓶颈。
(1)评估维度与挑战
业界通常会从几个维度对RAG系统进行量化评估:
- 检索相关性(找到的内容是否包含答案)
- 生成质量
- 语义准确性(回答的意思是否正确)
- 词汇匹配度(专业术语是否使用得当)
这些评估维度对应 RAG 当前面临的主要挑战。比如检索依赖性问题——如果检索系统召回了错误信息,再强的 LLM 也会“一本正经地胡说八道”。此外,对于需要跨多个文档进行综合分析的多跳推理问题,常见的 RAG 架构也普遍感到吃力。
(2)优化方向与架构演进
针对上述挑战,社区探索出了多种优化路径。在性能层面,可以通过索引分层(对高频数据启用缓存)和多模态扩展(支持图像/表格检索)来提升效率和能力边界。在架构层面,简单的线性流程正在被更复杂的设计模式所取代。如系统可以通过分支模式并行处理多路检索,或通过循环模式进行自我修正,更灵活的架构构建了更智能 RAG
RAG 已死?
随着大模型上下文窗口(Context Window)动辄达到百万甚至千万级别,我们似乎可以直接将整本书、整个知识库喂给大模型,让它自己去阅读理解,何必再费劲地搞“ 检索-增强-生成 ”这套流程?
这里需要厘清一个概念:
上下文工程泛指所有在生成前对输入给大语言模型的上下文进行组织、优化和管理的技术。而 RAG 是一种动态、实时的信息获取机制,是上下文工程的一种高级实现方式。它的核心是检索这个动作,而不是增强这个结果。
把长文本一股脑塞进上下文窗口一般面临着大海捞针的困境:
- 精度问题:在数百万字的文本中,LLM的注意力是有限的,关键信息很容易被淹没在海量无关内容中,导致Lost in the Middle(中间淹没现象)。
- 成本问题:处理超长上下文的计算成本和时间成本是巨大的。对于每次查询都重复处理整个知识库,无异于杀鸡用牛刀。
- 动态性问题:如果知识库更新了,你需要重新将整个新知识库塞入上下文。这在实时应用,特别是许多企业级场景当中几乎不可行。
而 RAG 恰恰是解决上述问题的优雅方案,RAG 已死” 是典型的技术伪命题
未来趋势:Agentic RAG
目前走在前沿的智能体 RAG(Agentic RAG)是对 RAG 进行了范式革命。在这个架构中,RAG 不再是整个系统的核心,而是被降级为一个可供调用的工具,主角变成了 Agent。
当 AI Agent 接到一个复杂任务,比如「 分析并对比 A、B 两家公司最新财报中的AI战略 」,它会开始以下动作:
规划
“我需要先找到A公司的财报,再找到B公司的财报。”
调用工具
“调用 RAG 工具,在内部文档库中查询「 A公司最新财报 」。” 然后,“再次调用 RAG 工具,查询「 B公司最新财报 」。”
反思与整合
AI Agent 会评估 RAG 返回的内容是否准确。如果信息不足,它甚至可能决定调用「 网页搜索工具 」去网上查找。最后,它将所有收集到的信息进行整合、对比,并生成最终的分析报告。
在这个模式下,RAG和长上下文窗口的协作关系变得无比清晰:
RAG负责输入
作为最高效的信息获取工具,它将为 AI Agent 提供精准、可靠、可追溯的外部知识。
长上下文负责工作台
广阔的上下文窗口成为了 AI Agent 进行多步推理、整合不同来源信息、维持对话记忆的工作内存。
RAG 正在以更加成熟和强大的形态,深度融入未来的 AI 技术栈,接下来关于RAG的构建展开论述。
基于 LangChain 框架的 RAG 实现
四步构建最小可行系统分别是数据准备、索引构建、检索优化和生成集成提到四步构建最小可行系统分别是数据准备、索引构建、检索优化和生成集成。下面将围绕这四个方面来实现一个基于 LangChain 框架的 RAG 应用。
初始化设置
首先进行基础配置,包括导入必要的库、加载环境变量以及下载嵌入模型。
import os
# os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'
from dotenv import load_dotenv
from langchain_community.document_loaders import TextLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_core.prompts import ChatPromptTemplate
from langchain_deepseek import ChatOpenAI

# 加载环境变量
load_dotenv()
数据准备
- 加载原始文档: 先定义Markdown文件的路径,然后使用
TextLoader加载该文件作为知识源。python markdown_path = "../../data/C1/markdown/easy-rl-chapter1.md" loader = TextLoader(markdown_path) docs = loader.load()
- 文本分块 (Chunking): 为了便于后续的嵌入和检索,长文档被分割成较小的、可管理的文本块(chunks)。这里采用了递归字符分割策略,使用其默认参数进行分块。当不指定参数初始化
RecursiveCharacterTextSplitter()时,其默认行为旨在最大程度保留文本的语义结构:- 默认分隔符与语义保留: 按顺序尝试使用一系列预设的分隔符
["\n\n" (段落), "\n" (行), " " (空格), "" (字符)]来递归分割文本。这种策略的目的是尽可能保持段落、句子和单词的完整性,因为它们通常是语义上最相关的文本单元,直到文本块达到目标大小。 - 保留分隔符: 默认情况下 (
keep_separator=True),分隔符本身会被保留在分割后的文本块中。 - 默认块大小与重叠: 使用其基类
TextSplitter中定义的默认参数chunk_size=4000(块大小)和chunk_overlap=200(块重叠)。这些参数确保文本块符合预定的大小限制,并通过重叠来减少上下文信息的丢失。
python text_splitter = RecursiveCharacterTextSplitter() texts = text_splitter.split_documents(docs)
- 默认分隔符与语义保留: 按顺序尝试使用一系列预设的分隔符
索引构建
数据准备完成后,接下来构建向量索引:
- 初始化中文嵌入模型: 使用
HuggingFaceEmbeddings加载之前在初始化设置中下载的中文嵌入模型。配置模型在CPU上运行,并启用嵌入归一化 (normalize_embeddings: True)。python embeddings = HuggingFaceEmbeddings( model_name="BAAI/bge-small-zh-v1.5", model_kwargs={'device': 'cpu'}, encode_kwargs={'normalize_embeddings': True} ) - 构建向量存储: 将分割后的文本块 (
texts) 通过初始化好的嵌入模型转换为向量表示,然后使用InMemoryVectorStore将这些向量及其对应的原始文本内容添加进去,从而在内存中构建出一个向量索引。python vectorstore = InMemoryVectorStore(embeddings) vectorstore.add_documents(texts)
查询与检索
索引构建完毕后,便可以针对用户问题进行查询与检索:
- 定义用户查询: 设置一个具体的用户问题字符串。
python question = "文中举了哪些例子?"
- 在向量存储中查询相关文档: 使用向量存储的
similarity_search方法,根据用户问题在索引中查找最相关的k(此处示例中k=3) 个文本块。python retrieved_docs = vectorstore.similarity_search(question, k=3)
- 准备上下文: 将检索到的多个文本块的页面内容 (
doc.page_content) 合并成一个单一的字符串,并使用双换行符 ("\n\n") 分隔各个块,形成最终的上下文信息 (docs_content) 供大语言模型参考。python docs_content = "\n\n".join(doc.page_content for doc in retrieved_docs)
使用
"\n\n"(双换行符) 而不是"\n"(单换行符) 来连接不同的检索文档块,主要是为了在传递给大型语言模型(LLM)时,能够更清晰地在语义上区分这些独立的文本片段。双换行符通常代表段落的结束和新段落的开始,这种格式有助于LLM将每个块视为一个独立的上下文来源,从而更好地理解和利用这些信息来生成回答。
生成集成
最后一步是将检索到的上下文与用户问题结合,利用大语言模型(LLM)生成答案:
- 构建提示词模板: 使用
ChatPromptTemplate.from_template创建一个结构化的提示模板。此模板指导LLM根据提供的上下文 (context) 回答用户的问题 (question),并明确指出在信息不足时应如何回应。python prompt = ChatPromptTemplate.from_template("""请根据下面提供的上下文信息来回答问题。 请确保你的回答完全基于这些上下文。 如果上下文中没有足够的信息来回答问题,请直接告知:“抱歉,我无法根据提供的上下文找到相关信息来回答此问题。” 上下文: {context} 问题: {question} 回答:""" ) - 配置大语言模型: 初始化
ChatOpenAI客户端,配置所用模型(glm-4.7-flash-free)、生成答案的温度参数(temperature=0.7)、最大Token数 (max_tokens=2048) 以及API密钥(从环境变量加载)和 url。python llm = ChatOpenAI( model="glm-4.7-flash-free", temperature=0.7, max_tokens=2048, api_key=os.getenv("DEEPSEEK_API_KEY") base_url="https://aihubmix.com/v1" ) - 调用LLM生成答案并输出: 将用户问题 (
question) 和先前准备好的上下文 (docs_content) 格式化到提示模板中,然后调用ChatDeepSeek的invoke方法获取生成的答案。python answer = llm.invoke(prompt.format(question=question, context=docs_content)) print(answer)
完整代码
import os
# hugging face镜像设置,如果国内环境无法使用启用该设置
# os.environ['HF_ENDPOINT'] = 'https://hf-mirror.com'
from dotenv import load_dotenv
from langchain_community.document_loaders import UnstructuredMarkdownLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_huggingface import HuggingFaceEmbeddings
from langchain_core.vectorstores import InMemoryVectorStore
from langchain_core.prompts import ChatPromptTemplate
from langchain_openai import ChatOpenAI
load_dotenv()
markdown_path = "../../data/C1/markdown/easy-rl-chapter1.md"
# 加载本地markdown文件
loader = UnstructuredMarkdownLoader(markdown_path)
docs = loader.load()
# 文本分块
text_splitter = RecursiveCharacterTextSplitter()
chunks = text_splitter.split_documents(docs)
# 中文嵌入模型
embeddings = HuggingFaceEmbeddings(
    model_name="BAAI/bge-small-zh-v1.5",
    model_kwargs={'device': 'cpu'},
    encode_kwargs={'normalize_embeddings': True}
)
# 构建向量存储
vectorstore = InMemoryVectorStore(embeddings)
vectorstore.add_documents(chunks)
# 提示词模板
prompt = ChatPromptTemplate.from_template("""请根据下面提供的上下文信息来回答问题。
请确保你的回答完全基于这些上下文。
如果上下文中没有足够的信息来回答问题,请直接告知:“抱歉,我无法根据提供的上下文找到相关信息来回答此问题。”

上下文:
{context}

问题: {question}

回答:"""
                                          )
# 配置大语言模型
# 使用 AIHubmix
llm = ChatOpenAI(
model="glm-4.7-flash-free",
temperature=0.7,
max_tokens=4096,
api_key=os.getenv("DEEPSEEK_API_KEY"),
base_url="https://aihubmix.com/v1"
)
# llm = ChatOpenAI(
# model="deepseek-chat",
# temperature=0.7,
# max_tokens=4096,
# api_key=os.getenv("DEEPSEEK_API_KEY"),
# base_url="https://api.deepseek.com"
# )
# 用户查询
question = "文中举了哪些例子?"
# 在向量存储中查询相关文档
retrieved_docs = vectorstore.similarity_search(question, k=3)
docs_content = "\n\n".join(doc.page_content for doc in retrieved_docs)
answer = llm.invoke(prompt.format(question=question, context=docs_content))
print(answer)
当然这个距离上生产环境还有相当远的一段距离,OpenAI/LangChain 是个好工具,但企业场景下要面对的是:
- 大规模文档的增量更新,不可能每次全量重建索引
- 多租户隔离和权限控制,不同部门看到的知识库不一样
- 高并发下的检索性能,模型调用的成本控制和容错
- 请求风控,防止用户套取敏感信息或恶意攻击
- 模型负载均衡,多供应商切换和降级策略
- 可观测性,效果监控和用户反馈收集
这些问题 LangChain 的 QuickStart 不会告诉你,但实际业务场景肯定要面对。
所以具体的设计细节将在后面的博客展开。